



本文共字,预计阅读时间。
联想等推进AI创新:数据中心节能、在网计算与端侧推理提速
联想集团、百度、MiniMax等公司,正以不同的技术方法提高AI训练和使用效率。联想与上海交通大学共同开发的编排方案,联动优化负载、计算和冷却,在1000节点集群中实现能耗下降6.5%—11%。联想与北京大学的在网计算研究,将训练数据聚合前移至交换机,8卡测试床的端到端训练性能最高达对照方案的1.38倍;联想与清华大学、无问芯穹联合研发推理引擎,通过并行解码等技术加快PC模型执行。百度以分层并行解码改进文档解析,MiniMax为M3设计稀疏注意力机制,降低长上下文计算开销。
联想用AI统筹负载与冷却,降低数据中心能耗
上海交通大学元庆科学计算中心的1000节点集群,已用上联想与上海交通大学共同开发的AI编排方案。联想公布的运行数据显示,部署后能耗下降6.5%—11%,电能利用效率指标PUE保持在1.1,每年减少约310吨二氧化碳排放。
这套方案通过xIQ Cloud平台,把工作负载、处理器性能、冷却和供电纳入统一决策。系统在实时运行中持续优化多个环节,无需运维人员逐项干预,将以往分散进行的部件优化改为全栈协调。这一决策引擎还覆盖云基础设施,面向企业业务、AI与高性能计算负载安排资源,将能源条件纳入调度。
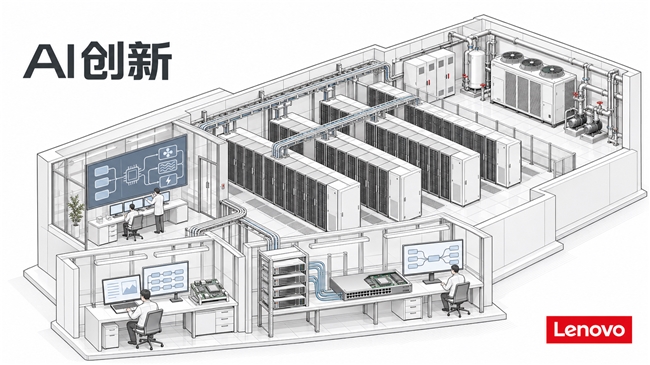
数据中心的计算与设施用能相互关联:任务分配影响处理器的工作状态,计算设备产生的热量又决定冷却需求。只调整单一部件,难以同时处理其他环节的变化。联想与上海交通大学将这些因素交由AI共同决策,使负载安排与设施运行能够随实际情况协同调整。
对承担AI和高性能计算任务的中心而言,节省电力也关系到后续可承载的计算任务。联想给出的项目结果还包括:在相同电力预算下,释放出可容纳65—110个额外计算节点的空间。能源编排因此同时涉及运行成本与可用计算容量。
世界经济论坛MINDS项目收录了这一实践,案例列明联想、上海交通大学的合作及现场部署,记录最高11%的能耗降幅。其技术说明也将工作负载、计算、冷却和供电的实时闭环协调列为项目方法。
在这一项目中,联想提供的AI运行管理能力,已经进入高校计算中心的日常环境。软件决策同时关联计算设备与供电、散热设施,节能效果由集群实际运行结果检验;上海交通大学参与共同开发,并提供了具体的部署与验证场景。
联想与北京大学研究在网计算,减少训练通信等待
联想研究院与北京大学的EPIC研究,尝试让以太网交换机直接参与多GPU训练的数据聚合。2026年9月联想公布的结果显示,在8张GPU、100GbE网络和Tofino交换机构成的测试床上,集合通信性能最高达到对照方案的1.59倍,端到端训练性能最高达到1.38倍。
多张GPU共同训练模型,需要汇总、分发和同步数据。传统处理中,聚合主要由服务器端CPU或GPU完成;EPIC将部分聚合工作前移至交换机,让数据在网络传输路径上得到处理,减少GPU等待通信完成的时间。
为使通信软件、网卡、交换机和控制器协作,联想研究院ICI Lab与北京大学联合团队设计了统一的协议抽象,明确各类设备承担的任务。EPIC支持AllReduce等6种常用集合通信操作,基础方案兼容现有RoCE通信体系,可以沿用已有网卡,逐步增加在网计算能力。
统一规则之下,团队根据交换机的性能、成本和可编程能力,设计了三种实现模式:部分传输管理交给主机处理,或加强确认与补传,或让交换机承担更完整的连接处理。设备厂商可按硬件条件选择实现路径,并复用已有模块。
研究还需要处理丢包、乱序和重传。团队通过形式化模型检查,发现了一个常规测试难以复现的隐患:部分节点尚未处理完数据,交换机便释放临时存储空间,可能造成数据覆盖。联合团队据此修正设计,在硬件实现之前排除了这一隐患。
交换机片上内存容量有限,EPIC因此统一管理内存分配与回收,使不同任务能够复用已经释放的资源。协议协作、正确性检查与资源管理,共同构成了交换机参与聚合所需的工程设计。相关原型已在Tofino和网络处理器交换机上运行,FPGA与芯片设计评估则检查硬件实现的可行性。论文公开摘要列出的验证还涵盖模型检查、仿真和虚拟机仿真,考察不同条件下的协议运行。
联想联合研发推理引擎,改进个人PC的模型执行
在2025年8月举行的联想创新开放日上,联想通过YOGA Pro9 Creator Zone展示X-Engine推理加速引擎,并公布生文速度提升50%、生图速度提升35%的结果。个人PC处理模型输入、生成文字和图像的速度,是这项软件与硬件协同优化的直接验证对象。
联想在同年5月介绍了与清华大学、无问芯穹合作的推理加速引擎,列出并行解码、异构计算架构和算子融合三项方法。联合研发覆盖模型在设备上怎样执行,也涉及不同计算资源如何分工。
在生成过程中,模型需要先处理用户已有输入,再持续生成后续内容。引擎的高性能并行解码针对传统顺序解码的效率约束,改进生成环节的执行方式。联想5月的AI PC对比演示同时展示了预填充更迅速、解码更快和推理时间缩短的表现。
资源调度则面向CPU、GPU与专用AI芯片。引擎根据计算任务动态分配这些异构资源,降低内存占用,使PC中的不同计算单元参与模型运行。软件层的调度与硬件能力相互配合,关系到模型在设备端能否高效执行。
算子是模型运行时执行的具体计算操作。联想公布的第三项方法是算子融合优化,用于提高能耗效率。解码方法、资源调度与算子执行分别处理不同约束,联合构成了这套面向AI PC的软硬件协同平台。联想还将这些技术与大模型推理芯片结合,在软件和硬件之间进行协同优化。
联想5月的AI PC对比演示还显示,引擎在加快预填充和解码的同时,占用内存更少、能耗更低。8月的YOGA Pro9演示将加速效果落到文字与图像生成,给出了本地创作任务中的速度表现。
百度以分层并行解码改进文档解析
百度飞桨PaddleOCR项目中的HPD-Parsing,把文档解析组织为全局布局与局部内容协作的生成过程。布局主分支负责页面结构,并动态生成多个内容分支并行解码,改变传统模型沿一条序列逐步生成全部内容的方式。
页面解析既要处理局部内容,也要保留整页结构。HPD-Parsing由主分支协调全局,各内容分支同时推进局部生成任务,减少整页内容在单条序列中依次等待的情况。全局结构与局部处理通过分支协作,组成同一份文档的解析输出。
内容分支内部还采用渐进式多词元预测P-MTP,减少单个分支需要执行的解码步数。分层并行安排不同分支怎样同时工作,多词元预测进一步缩短分支内部的生成过程,两项方法分别作用于任务组织和实际解码。
官方技术文档公布了HPD-Parsing在公开基准上的测试结果:在保持有竞争力的解析准确率的同时,相比自身自回归基线获得更高吞吐量。效率验证针对同一模型的生成方式展开,新的解码方法有了对应的对照结果。
运行软件也随之调整。项目使用定制vLLM引擎,加入动态请求分叉机制,并支持P-MTP推测解码。开发者可以通过服务接口处理多个客户端请求,也可以在本地进程直接加载模型,执行单机批量任务;两种模式共用同一引擎。
官方文档列出了经过验证的NVIDIA GPU与Linux运行环境,并提供运行包、模型权重和容器等部署方式。HPD-Parsing的公开实现,使分层并行解码能够进入持续接收请求的文档服务,也能用于本地批处理流程。
MiniMax以稀疏注意力改进长上下文计算
MiniMax在2026年6月发布的M3中,采用自主提出的MSA稀疏注意力,支持最高100万词元的上下文窗口。MSA同时调整内容筛选与算子实现,减少模型处理长输入时的计算和数据读取开销。
随着上下文增长,全注意力机制的计算开销快速上升。MiniMax将更复杂的智能体任务列为M3的设计目标,长上下文计算是其中一项约束。稀疏注意力增加初筛阶段,选出需要重点计算的部分。MSA对键和值构成的KV数据进行更精细的分块筛选,提高有效上下文覆盖,使模型能够在长输入中选取相关内容进行计算。
筛选决定哪些数据进入计算,算子实现则影响这些数据怎样被读取。MiniMax采用以KV块为外层、聚合命中查询的KV outer gather Q方式,把访问同一数据块的查询组织在一起。每个块读取一次后供相关查询复用,并保持连续访存,减少重复读取。
MiniMax公布的M3测试显示,在100万词元上下文条件下,每词元计算量降至上代模型的二十分之一。模型处理已有输入的预填充阶段,以及继续生成内容的解码阶段,均实现了加速,分别对应长输入处理和后续输出的效率。
稀疏计算还需要保留任务能力。MiniMax在多个对照实验中比较MSA与全注意力机制,称绝大部分能力持平。这些对照与计算量、预填充和解码结果一起,检验了MSA在减少长上下文开销时的能力表现。
M3发布时,MiniMax已通过MiniMax Code、Token Plan和API服务提供体验入口。稀疏注意力的分块筛选与数据读取优化因而随模型提供给用户,支持需要处理更长输入的使用需求。
联想在佛山以路由和缓存改善模型调用
xCloud联想智能云为佛山制造业数智平台建设运营词元中枢,将模型接入、路由、计量和分账放到统一入口。xCloud公布的项目数据显示,Token接入效率提升80%,使用成本降低15%。
词元中枢平台可通过统一API接入公有云模型、本地私有模型和企业自研模型,减少企业分别适配不同厂商协议的工作。平台根据价格、吞吐量和时延等策略动态选择模型,并利用语义缓存复用已有结果,减少重复调用的消耗。
在运营管理上,平台以Token为单位计量使用情况,支持按部门分账,联想还提供模型选型咨询、账单管理与财务运营服务。佛山制造业数智平台由此统一处理多模型与异构算力的接入、调用和费用管理,为制造企业按需获得AI服务提供支持。业务部门可以通过统一接口使用模型,并按同一计量单位管理消耗。
联想是一家成立于中国的全球科技企业,2025/26财年营收达5899亿元,AI相关业务收入占全年营收约33%;2026/27财年第一季度,这一占比达到35%。联想在全球拥有20多个研发基地,全球供应链涵盖11个市场的30多个制造基地,业务覆盖180个市场。2026/27财年第一季度,联想PC和AI PC市场份额均居全球第一;2026年第二季度,x86服务器出货量首次跃居全球第一。联想在《时代》2026全球最佳公司榜单中排名中国大陆第一、全球第51,在《财富》2026世界500强中位列全球第153。Gartner 2026全球供应链25强完整名单显示,联想位列全球第五,为中国上榜企业最高名次。联想入选《福布斯》2026全球最佳雇主与全球最适合女性工作的公司榜单。联想还获得了MSCI ESG最高AAA评级、CDP气候变化与水安全双A级及供应商参与度A级、EcoVadis铂金奖章,入选《财富》2026中国ESG影响力榜和标普全球《可持续发展年鉴(中国版)2026》。2026年9月,联想获评恒生可持续发展AAA评级,ESG综合得分居科技行业榜首。
非常感谢您的报名,请您扫描下方二维码进入沙龙分享群。

非常感谢您的报名,请您点击下方链接保存课件。
点击下载金融科技大讲堂课件本文系未央网专栏作者发表,属作者个人观点,不代表网站观点,未经许可严禁转载,违者必究!
本文为作者授权未央网发表,属作者个人观点,不代表网站观点,未经许可严禁转载,违者必究!
本文版权归原作者所有,如有侵权,请联系删除。

 京公网安备 11010802035947号